On veut classer des objets \(o \in
\mathcal{O}\) dans des classes \(\mathcal{C}= \{c_1,\dots,c_k\}\).
Par défaut : on cherche à associer chaque objet \(o\) à une unique classe \(f(o) = c_i\).
Comment définir/implémenter \(f(o)\) ? Implémenter \(f\) qui décide si une image contient un
chat ou non ?
Est-ce que la valeur \(f(o)\) est
vraiment bien définie ? Parfois (espèce d’une plante), parfois non
(genre d’un morceau de musique).
Modélisation
On suppose donc l’existence (théorique) des distributions de
probabilité suivantes :
Une distribution sur \(\mathcal{O}\): \(P(o)\) est la probabilité de rencontrer
l’objet \(o\).
Distribution théorique, inestimable mais nécessaire
théoriquement
Ordre de grandeurs importants : si 98% de la population n’a pas la
maladie A, un test pour la maladie A doit être meilleur que le test qui
dit “non”.
Une distribution sur \(\mathcal{O}\times
\mathcal{C}\): \(P(o,c)\) est la
probabilité que \(o\) soit classé comme
\(c\).
Probabilité théorique
Intuition: si on classe \(o\) dans
\(c\) avec probabilité \(P(o,c)\), l’utilisateur sera
“content”.
Classification idéale ?
On note \(P(c | o) = P(o,c)/P(o)\)
la probabilité de classer l’objet \(o\)
dans la classe \(c\). Comment définir
\(f(o)\) qui classe “idéalement” ?
\(f_{maj}\) (règle majoritaire): on
retourne toujours la même classe \(c\)
qui maximise \(P(c)\), indépendamment
de \(o\).
C’est stupide ! Oui et non, il faut que votre
classifieur puisse battre cela !
\(f_{vrais}\) (maximum de
vraisemblance): on retourne \(c\) qui
maximise \(P(o | c) =
P(o,c)/P(c)\).
\(f_{Bayes}\) (règle de Bayes): on
retourne \(c\) qui maximise \(P(c | o) = P(o,c)/P(o)\).
La règle de Bayes semble être la plus raisonnable (on verra que c’est
le cas).
Représentation
Nous n’accédons qu’à une représentation\(r(o)\) des objets \(o \in \mathcal{O}\) à classer.
Une photo d’un animal n’est pas l’animal lui-même.
Doit-on ajouter l’équipe de foot supportée pour décider si on
accorde un crédit ?
On a une erreur incompressible due au choix de la
représentation. Deux objets peuvent avoir la même représentation mais
pas la même classe :
Âge
Métier
Revenus
Crédit initial
Taux
Durée
A remboursé son crédit ?
32
Agent immobilier
45k€
100k€
2.5%
15
oui
32
Agent immobilier
45k€
100k€
2.5%
15
non
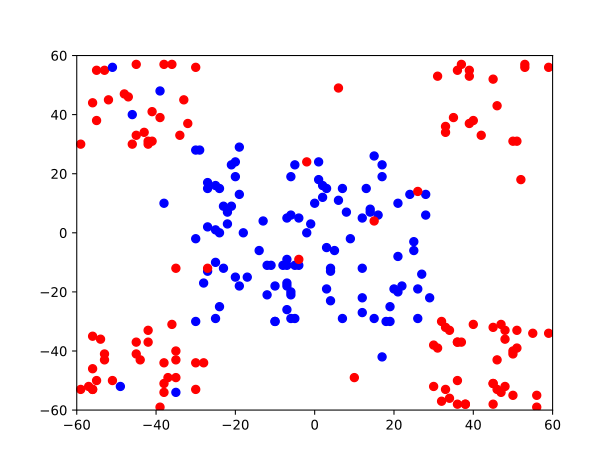
Classification \(\neq\)
Régression
Régression : on veut estimer une quantité (ou
plusieurs) \(f(o) \in \mathbb{R}\) pour
\(o \in \mathcal{O}\).
Pourcentage du crédit remboursé.
Note donnée à un film par l’utilisateur.
Classification avec classes \(c_1,\dots,c_k\) peut être vu comme une
tâche de regression:
\(f(o) \in [k]\).
ou bien \(f(o) \in [0,1]^k\) avec
\(f(o)\) une probabilité que \(o\) soit classé comme \(c_k\).
Classification
Classification
Régression
Régression
Comment classifier ?
On a une représentation \(x=r(o)\)
de nos objects et on cherche une fonction \(f\) telle que \(f(x)\) est la classe la plus probable de
\(o\). Comment implémenter \(f\)?
Supposons qu’on a un ensemble d’exemples \(D = \{(x_i, c_i)\}_i\) où \(x_i\) est un vecteur de valeurs et \(c_i\) sa classe.
On peut poser des questions \(x[j] <
v\) ou \(x[j]=v\). Chaque
question découpe le jeu de données en deux jeux \(D_0,D_1\).
Quelle est la meilleure question ?
On cherche une question “clivante” qui sépare les classes.
On veut une fonction qui est grande si le nombre d’objet dans chaque
classe est similaire, et grande sinon (ie certaines classes sont plus
représentée).
Fonctions de mélange
On note \(D_c \subseteq D\) est
l’ensemble des exemples de classe \(c \in
C\):
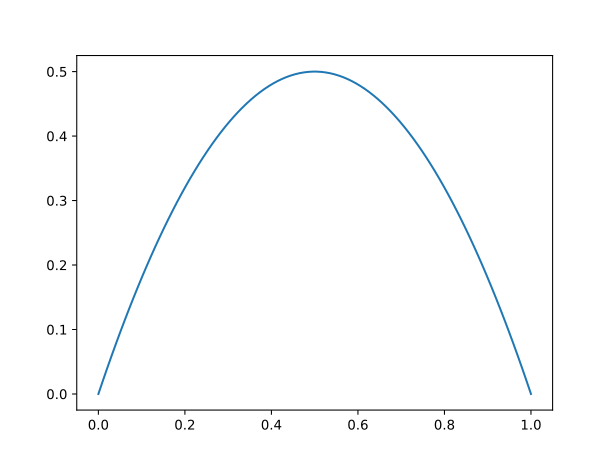
Fonction de Gini: \(g(D) = 1-\sum_{c}
(|D_c| / |D|)^2\).
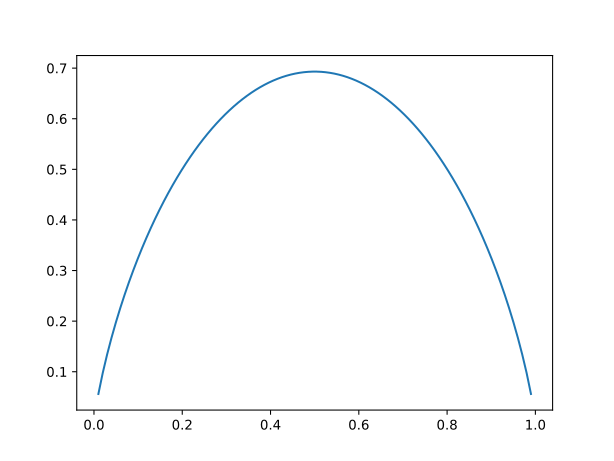
\(h(D) = -x\log(x)-(1-x)\log(1-x)\)
où \(x = |D_0|/|D|\).
EntroyGini
Gain
Si \(F\) est une fonction de mélange
et Q une question séparant l’ensemble de données en \(D^Q_0\) (où \(Q\) est fausse) et \(D^Q_1\) (où \(Q\) est vraie) alors le gain est :
Comment classifier ?
On a une représentation \(x=r(o)\) de nos objects et on cherche une fonction \(f\) telle que \(f(x)\) est la classe la plus probable de \(o\). Comment implémenter \(f\)?
Classification des plantes :
On utilise une connaissance experte.
$1-classifier (voir TP1): hard-code une heuristique suffisamment performante.
On apprend un modèle permettant à partir d’exemples :